URLから検索すれば問題ないのですが、勉強がてらスクレイピングしてみました。システム開発案件のうちpythonに関する案件を抽出してみます。
コンテンツ
環境
| python | 3.7 |
| Eclipse | 2019-06 (4.12) |
前提条件
- selenium を使用します
お課
python開発案件の情報取得スクレイピング&データ保存
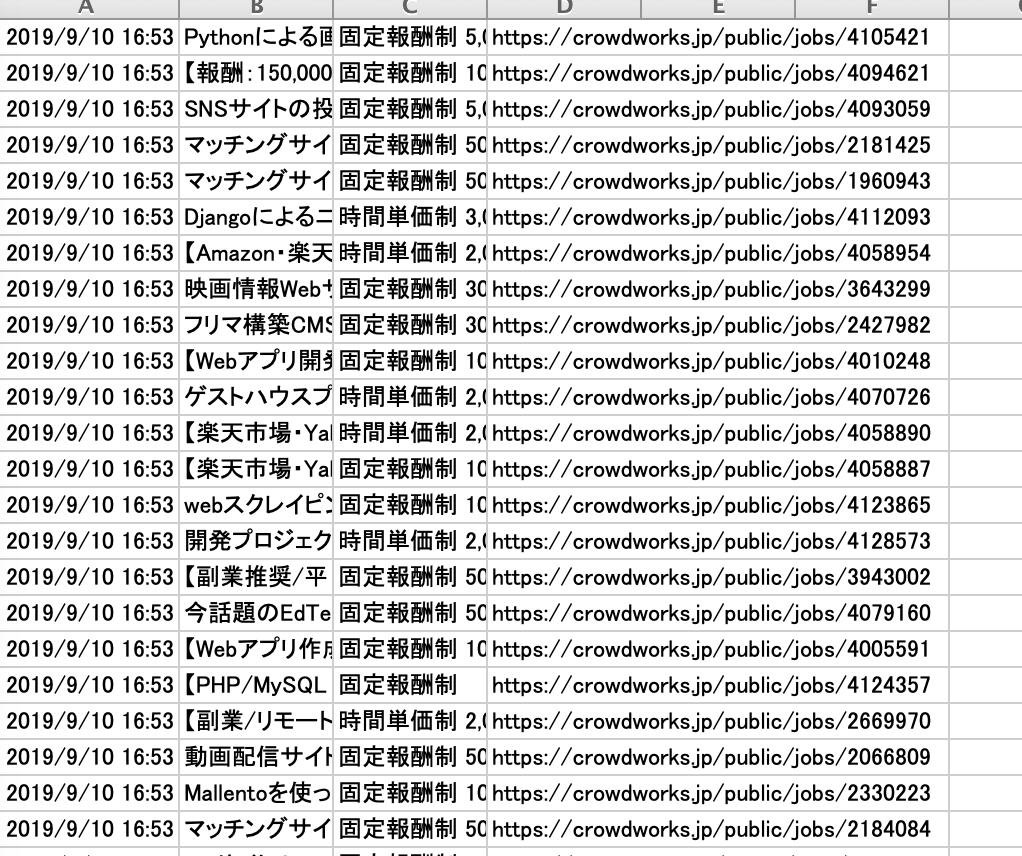
クラウドソーシングサイトにおける、システム開発案件のうちpythonを使用した案件のみを抽出してCSVファイルに保存。取得対象カラムは「取得日時」「案件名」「案件URL」「金額」の4種類。
元URL
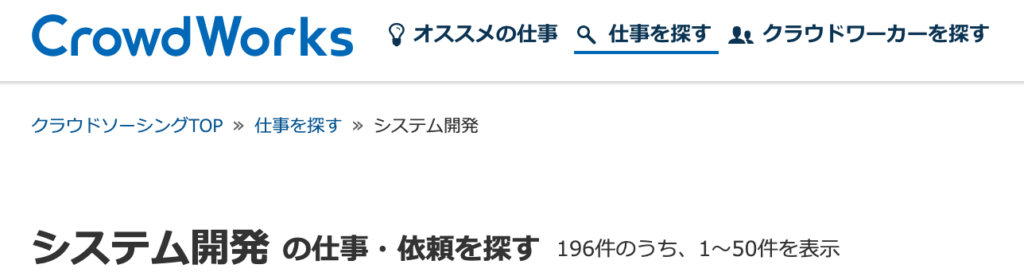
トップページではなく、既に存在するこちらのシステム開発案件の場所からにします
https://crowdworks.jp/public/jobs/group/development
実際のコード
coding:utf-8
 import csv
 import time #timeモジュールを呼び出します
 import mysql.connector #mySQLに接続します
 import requests, bs4 #requestsとは、httpの通信を行うことができるライブライ。ネットワーク処理をできるライブラリ
 from urllib.parse import urlparse, urljoin
 from bs4 import BeautifulSoup #HTML構文を解析する為のパッケージ
 from datetime import datetime
 from selenium import webdriver
 from urllib.request import(
     urlopen,
     Request,
 )#urllibとは・・・インターネットにアクセスすることが出来るパッケージ
 requestsモジュールとは・・・http通信ライブラリで、webサイトの情報取得や画像の収集を簡単に行うことが出来る。
 def crowdworks(): #クラウドワークスのシステム開発案件URLの取得
     res = requests.get('https://crowdworks.jp/public/jobs/group/development')
     res.raise_for_status()
     soup = bs4.BeautifulSoup(res.text, "html.parser")
     # print(soup) #htmlのコード全て表示できる
     driver = webdriver.Chrome(executable_path='XXXXXXXXXXXXXXXXXXXXXXXXXX') #絶対パスを入れます
     driver.get("https://crowdworks.jp/public/jobs/group/development")
     time.sleep(1)
     search_box=driver.find_element_by_name("search[keywords]") #検索ボックスを探します search[keywords]は検証時のnameの要素より。
     search_box.send_keys("python") #検索ボックスに左記を入れます
     search_box.submit() #検索ポスト(submit)の実行
     time.sleep(5)
     soup = bs4.BeautifulSoup(driver.page_source,"html.parser") #bs4を使ってこのページソースの文字列を再解析してみます。
     driver.quit() #ブラウザを閉じる
     while True: #永久に実行させます
         if datetime.now().second == 1: #○時△分1秒以外の時には、作動し続ける
             continue
         with open("crowdworks.csv", mode="a", encoding="utf-16") as f:
             current_time = datetime.now().strftime("%Y/%m/%d %H:%M:%S") #現在の時刻を年、月、日、時、秒で取得
             writer = csv.writer(f, dialect="excel-tab", delimiter="\t") #エクセルのたぶ区切り
             data_array = [] #整列させる
             search_results = soup.find_all("div", attrs={"class": "search_results"})
             for job_data in search_results:
                 # print(job_data)
                 # 各案件を抽出
                 for item in job_data.find_all('li', attrs={"data-jobs-list-item": True}):
                     # タイトルの抽出
                     item_title = item.find("h3", attrs={"class": "item_title"})
                     # 金額の抽出
                     payment = item.find("div", attrs={"class": "entry_data payment"})
                     # URLの抽出(<a data-item-title-linkのタグのhrefの値を取得する )
                     rel_url = item.find("a", attrs={"data-item-title-link": True}).get("href")
                     # print(rel_url)
                     # URLの合成
                     abs_url = urljoin(res.url, rel_url)
                     # 1行に出力するデータを用意
                     data_array.append(current_time)
                     data_array.append(item_title.text.strip())
                     data_array.append(payment.text.strip())
                     data_array.append(abs_url)
                     # 1行分のデータをCSVに書き出し
                     writer.writerow(data_array)
                     # 1行分データをクリア
                     data_array = []
             print(current_time) #時間の表示
             f.close() #ファイル破損防止の為に閉じる
 if name=="main":
     crowdworks()
実行結果
まとめ
後は実行結果を、GoogleAPIと連動させて自動的にメールを送ってくるようにしたり、組み合わせられれば随分と楽になりそうです。to be continue…


コメントを残す